Pikselipaino
Pääkirjoitus
Tämän vuorokauden kiinnostavimmissa julkaisuissa on yhteinen erikoisuus: yhtäkään uutta mallia ei koulutettu. Videomallin sisältä löytyi paikkamaalaustoiminto, jota kukaan ei ollut sinne rakentanut — se oli seurannut arkkitehtuurista koko ajan, kukaan ei vain ollut osoittanut sitä. Toinen tekijä siirsi kuvamallin kykyjä toiseen, eri sukupuuhun kuuluvaan malliin leikkaamalla ja liimaamalla painoja, ilman yhtäkään koulutusaskelta. Ja heinäkuussa julkaistu pelattava maailmamalli muuttui kaikkien saatavilla olevaksi pelkällä paketoinnilla, kun se käännettiin alan yleisimmän kirjaston kielelle.
Kolme vuotta on totuttu ajattelemaan, että uusi kyky vaatii uuden koulutusajon ja uuden julkaisun. Tämä viikko vihjaa toiseen suuntaan: valmiit painot ovat raaka-ainetta, ja niiden sisällä on enemmän kuin päällä lukee. Se joka lukee mallia tarkasti, saa siitä irti asioita, joita sen tekijä ei luvannut — ja joskus asioita, joita tekijä ei tiennyt lupaavansa. Sama kaari löytyy päivän klassikosta: CLIP rakennettiin vertaamaan kuvia ja tekstejä, ja siitä tuli vahingossa koko generatiivisen kuvakentän ohjausjärjestelmä. Löydetyt kyvyt ovat alan vanhin perinne. Uutta on vain se, kuinka nopeasti niitä nyt löydetään.
Uutiset
Videon paikkamaalaus löytyi mallin sisältä
Videon muokkauksen pyhä graali on pyyntö "vaihda tämä, äläkä koske mihinkään muuhun". Eilen julkaistu työkalu tekee sen MiniMax H3:lla — ilman uutta tarkistuspistettä, ilman adapteria, ilman ylimääräistä syötekanavaa. Ominaisuus oli mallissa jo, kukaan ei ollut vain kysynyt.
Paikkamaalaus eli inpainting tarkoittaa, että kuvasta tai videosta generoidaan uusiksi vain merkitty alue ja kaikki muu säilyy ennallaan. Kuvamalleissa tämä on arkea, mutta toteutus on käytännössä aina vaatinut jotain ylimääräistä: erikseen koulutetun inpainting-version, adapterin tai lisäkanavan, jota pitkin maski syötetään malliin. Videopuolella tilanne on ollut vielä hankalampi, koska korjauksen pitää pysyä paikallaan kymmenien ruutujen ajan — ja koska ääniraita menee tavallisesti uusiksi siinä sivussa.
Keskiviikkona diffusers-modular-tilille ilmestynyt julkaisu lähestyy asiaa toisin päin: se ei lisää malliin mitään, vaan käyttää rakennetta, joka MiniMax H3:ssa on ollut julkaisusta asti. H3 käsittelee videota ja ääntä yhtenä pakattuna sekvenssinä, jossa jokainen rivi kantaa omaa kohina-aikaleimaansa. Diffuusiomallin aikaleima kertoo, kuinka valmis kukin osa on: näin avainruutuankkuri voi istua sekvenssissä käytännössä puhtaana samalla, kun muut rivit vielä laskeutuvat kohina-aikataulua alaspäin. Mikään mallissa ei kuitenkaan määrää, mitkä rivit saavat olla valmiita. Kun valmiiksi merkitään mielivaltainen joukko rivejä — vaikkapa kaikki se, mihin ei haluta koskea — jäljelle jäävä on täsmälleen paikkamaalaus.
Käytännössä maski muuttuu rivikohtaiseksi aikaleimakentäksi: ykkösellä merkityt alueet kulkevat normaalin kohina-aikataulun läpi ja generoituvat uusiksi, nollalla merkityt pidetään puhtaina koko ajon ajan, jolloin lähdemateriaali säilyy koskemattomana. Pehmennetty maskinreuna saa väliarvot, joten sauma liukuu. Sama logiikka kattaa ääniraidan: se säilyy kokonaisena, ellei erillinen äänimaski toisin sano. Esimerkkiajossa klipistä vaihdettiin eläin toiseen yhden referenssivalokuvan perusteella kuudella askeleella — metsä, lumi, kameran liike ja alkuperäinen ääniraita pysyivät paikoillaan.
Julkaisu on rakennettu Hugging Facen Modular Diffusers -järjestelmän lohkoina, jotka ladataan H3:n vakiopainojen päälle. Mukana on myös riisuttu versio ilman tekstienkooderivaihetta hajautettuun ajoon, jossa enkooderi elää eri koneella. Tekijälle tämä on merkittävämpi asia kuin miltä hiljainen julkaisu näyttää: H3 on tämän hetken ladatuimpia videomalleja, ja sen ympärille on parissa viikossa kasvanut hahmolomakkeiden, ohjauslisäosien ja nyt paikkamaalauksen ekosysteemi — josta lisää juttusarjassa jäljempänä. Lehti kertoi H3:n toisesta kierroksesta numerossa 002.
Lähteet: minimax-h3-inpainting, MiniMax-H3, Hugging Face API (video-to-video, 48 h 20.8.)
WASD tuli kuvakirjastoon
Pelattavat maailmamallit ovat tähän asti olleet joko suljettuja palveluita tai tutkijoiden komentorivityökaluja. Tänä aamuna yksi niistä ilmestyi Diffusers-muodossa: viiden miljardin parametrin maailma, jota ohjataan näppäimistön kahdeksalla näppäimellä — ja joka lähettää kuvaa sitä mukaa kun laskee sitä.
Maailmamalli tarkoittaa videogeneraattoria, joka ei toista valmista klippiä vaan reagoi ohjaukseen: jokainen sekunti riippuu siitä, mitä käyttäjä juuri teki. Amap-konenäköryhmän ABot-World julkaistiin heinäkuussa, ja se on hienosäädetty Alibaban Wan2.2-TI2V-5B:stä — samasta kevytrungosta, jonka eilinen juttusarjan osa nimesi järkevimmäksi lähtökohdaksi tavallisille pelikorteille. Torstain vastaisena yönä Diffusers-tiimin kehittäjä julkaisi siitä Modular Diffusers -paketoinnin, joka muuttaa tutkimusartefaktin kirjaston vakiokappaleeksi.
Ajo alkaa lähtökuvasta ja hahmon viidestä referenssinäkymästä — pää, vasen, oikea, etu ja taka — ja etenee lohko kerrallaan: kolme latenttiruutua vastaa noin sekuntia videota. Jokaiselle lohkolle annetaan kahdeksan näppäimen vektori, jossa W, A, S ja D liikuttavat hahmoa ja I, J, K ja L kääntävät kameraa. Sama merkistö, jolla pelejä on ohjattu kolmekymmentä vuotta, on nyt diffuusioputken syöteparametri.
Paketoinnin kiinnostavin osa on suoratoisto. Putki osaa lähettää tapahtuman jokaisen kohinanpoistoaskeleen ja jokaisen valmistuneen lohkon jälkeen, joten kuvaa voi alkaa näyttää ennen kuin ajo on ohi — ja aidosti interaktiivisessa käytössä silmukan väliin voi kirjoittaa uusia näppäinkomentoja lohkojen välissä. Tämä on täsmälleen se rajapinta, jonka pelattava generatiivinen maailma tarvitsee, ja se tulee nyt kirjastosta valmiina eikä jokaisen projektin itse keksimänä. Rehellisyyden nimissä: integraatio on vielä arvioitavana eikä ole ehtinyt kirjaston pääversioon, joten ajaminen vaatii toistaiseksi kehitysversion. Muunnettu on vain itse muuntaja; VAE ja tekstienkooderi ladataan Wanin vakiojakelusta, jonka kanssa ne on todettu bitilleen samoiksi.
Laajempi asetelma tekee julkaisusta merkittävän. Pelattavia maailmamalleja on esitelty viime kuukausina tiheään, mutta näyttävimmät — Googlen Genie 3 etunenässä — ovat suljettuja palveluita, joiden painoja ei saa ja joihin pääsy on rajattu. ABot-World on Apache-2.0-lisensoitu, viiden miljardin parametrin kokoinen ja nyt ajettavissa samalla kirjastolla kuin tavallinen kuvagenerointi. Ero on sama kuin pelihallin ja kotikonsolin välillä: toinen on kokemus jonnekin mentäväksi, toinen esine, jonka voi omistaa, purkaa ja rakentaa uusiksi.
Lähteet: Diffusers-paketointi, ABot-World-0-5B-LF, koodirepositorio, Hugging Face API (image-to-video, 48 h 20.8.)
Oksastus ohitti hienosäädön
Nimimerkki julkaisi keskiviikkona demon, jonka saateteksti alkaa kyllästymisellä: hän on väsynyt asiantuntijoihin, jotka selittävät, ettei hänen tekemänsä ole mahdollista. Demossa Krea 2:n huomiokerrokset on istutettu Z-Image-Turboon — kahden eri arkkitehtuurin välillä, ilman yhtäkään koulutusaskelta.
Mallien yhdistely ilman koulutusta on yhteisön vanhimpia lajeja: saman perheen tarkistuspisteitä on sekoitettu keskenään Stable Diffusionin alkuajoista asti. Raja on kulkenut arkkitehtuurien välissä — kahta eri suvun mallia ei ole voinut yhdistää, koska kerrokset eivät vastaa toisiaan. Juuri sen rajan yli nimimerkki TenStripin demo astuu: siinä Krea 2 Turbo toimii luovuttajana, jonka huomiolohkojen komponentit sekoitetaan Z-Image-Turbon vastaaviin. Tekijä kutsuu menetelmäänsä magnitudipohjaiseksi huomiosekoitukseksi; käytännössä kummankin mallin kolmekymmentä lohkoa käydään läpi pareittain, ulottuvuuserot sillataan matriisihajotelmalla ja siirron voimakkuus säädetään komponenteittain — avain-arvo-parit varovasti, ulostuloprojektiot täysillä.
Valittu pari ei ole sattumaa, vaan siinä on ajatus. Z-Image-Turbo on tislattu malli: nopea, mutta käytännössä kouluttamaton, koska hienosäätö rikkoo tislauksen. Sen kykyjä ei siis voi parantaa tavallisin keinoin. Oksastus kiertää tämän kokonaan — tekijän sanoin muutos menee vahvistuksen ja tislauksen alapuolelle tavalla, johon koulutus ei pysty. Tuloksena on hänen mukaansa hienosäätötason muutos, joka syntyy sekunneissa, kun asetelma on kerran rakennettu. Väite jatkuu pidemmälle: sama menetelmä toimisi mihin tahansa diffuusiotransformeriin, kuvalle, videolle ja multimodaalille, ja niiden välillä ristiin — muttei vanhoihin U-Net-malleihin eikä kielimalleihin. Tekijä kertoo käyttävänsä samaa tekniikkaa omissa H3- ja LTX-projekteissaan.
Terve annos varauksia on paikallaan. Kyseessä on yhden tekijän demo, jonka vaikutukset ovat toistaiseksi tekijän omankin arvion mukaan maltillisia, joskin vahvistuneet strategiaa iteroimalla. Vertaisarviota ei ole, ja mittarit ovat silmämääräisiä. Mutta olennainen ero moneen kotikutoiseen läpimurtoväitteeseen on, että kaikki on auki: oksastusskripti on ladattavissa ja tarkka komentorivi parametreineen dokumentoitu, joten kuka tahansa voi toistaa kokeen tai osoittaa sen tyhjäksi. Tekijä tosin varoittaa, ettei työ ole käsityönä mielekästä — kerroskohteiden selvittäminen, komponenttien sovitus ja kattavuuden arviointi vaativat joko koneoppimistutkinnon tai tekoälyavustajan, joka jaksaa iteroida. Jos menetelmä kestää tarkastelun, seuraus on kutkuttava: mallien suvut, jotka ovat tähän asti eläneet erillään, alkavat risteytyä.
Lähteet: Krea2Zimage-demo, Z-Image-Turbo, Krea-2-Turbo, Hugging Face API (text-to-image, 48 h 20.8.)
Lyhyet
Krea 2 Raw neljäsosaan: yhteisön uudeksi pohjamalliksi noussut Krea 2 sai Raw-versiostaan SVDQuant-paketin: painot esitetään neljällä bitillä kuudentoista sijaan, ja pieni matriisihajotelmaan perustuva apurunko sieppaa kvantisoinnin pahimmat virheet. Muistintarve putoaa noin neljäsosaan. Jakelu on saman yhteisölisenssin ja pääsypyynnön takana kuin pohjamallikin — kutistaminen ei kierrä lisenssiä, kuten tällä palstalla on ennenkin todettu.
Kuusi gigatavua riittää: anime-yhteisön suosiman Illustrious-sukuisen One Obsession -rungon versiosta 24 ilmestyi kokeellinen INT8-paketti ComfyUI:hin. Tekijä testasi sen kuuden gigatavun GTX 1660 Superilla — kortilla, jonka moni on jo ehtinyt julistaa kuolleeksi — ja raportoi selvän nopeutuksen. Laatuarvio on riisutun rehellinen: "kelpaa kouluttamattomalle silmälleni". Kvantisointiaalto ei siis koske vain uutuuksia, vaan myös yhteisön vanhat suosikit pakataan nyt pienempiin kortteihin sopiviksi.
Luuranko Applen piirille: YOLOv8 Pose ilmestyi Core ML -käännöksinä kolmessa koossa, 6,8–53 megatavua, ajettavaksi Macin suorittimella, näytönohjaimella tai Neural Engine -piirillä. Paketit ovat osa avointa Hugging Mac -alustaa, joka rakentaa asento-ohjattuja sovelluksia ja pelejä macOS:lle. Ihmisasennon tunnistus on se hiljainen perusta, jonka päällä hahmonohjaus ja liikkeensiirto lepäävät — ja harvoin liikahtava keypoint-alue liikahti nyt Applen suuntaan.
Videolatentit lainasilmin: Singaporen ja Oxfordin yliopistojen V-RAE tuo videopuolelle saman ajatuksen, josta numero 005 kertoi kuvien osalta: generatiivisen mallin latenttitila rakennetaan valmiin, jäädytetyn näköenkooderin päälle sen sijaan että opetettaisiin oma tyhjästä. Tarjolla on neljä varianttia eri enkooderien varaan — muun muassa DINOv3:n ja SigLIP2:n — ja kevyt ajallinen tiivistys poistaa peräkkäisten ruutujen toisteisuuden. Mukana tulevat myös valmiit videogeneraattorit vertailuaineistoille.
Kielimalli oppi kirjoittamaan kuvamallille: Qwen-Image-Edit-2511:n rinnalle julkaistiin Gemma-4-pohjainen kehotteenlaajennin, joka lukee muokkauskäskyn ja lähtökuvat ja kirjoittaa niistä yksityiskohtaisen ohjeen. Koulutus tehtiin vahvistusoppimisella, jossa palkkion antoi kolmas malli arvioimalla valmiit muokkaustulokset. Ketjussa on siis kielimalli, joka oppii puhumaan kuvamallille, ja tuomarimalli, joka katsoo kuvia — työnjako, joka vielä vuosi sitten olisi kuulostanut vitsiltä, on nyt julkaisukäytäntö. Itse muokkain esiteltiin juttusarjassa numerossa 002.
Juttusarja · Mitä tällä oikeasti tekee — osa 7
MiniMax H3: hahmolomake, jonka videomalli tekee sivutyönään
Kuvasta kuvaksi -trendilistan kärjessä ei ole tällä viikolla kuvamallia, vaan videomallin työnkulku, joka tuottaa still-kuvia. Eilisissä Lyhyissä se sai kappaleen; tänään katsotaan kunnolla, miten hahmolomake tehdään ja mihin sitä käytetään.
MiniMax H3 on tämän kesän puhutuimpia videomalleja: se suunnittelee kohtauksen merkitystasolla ennen pikseleitä, tuottaa kuvan ja äänen yhdessä ja — tämän jutun kannalta olennaisesti — ottaa vastaan jopa yhdeksän referenssikuvaa kerralla. Lehti kertoi sen toisesta kierroksesta numerossa 002, ja tämän numeron pääuutinen rakentuu samalle rungolle. Nopeutettu Turbo-versio ja yhteisön GGUF-paketit, joita on ladattu jo kolme neljännesmiljoonaa, tekevät siitä ajettavan myös ilman konesalia.
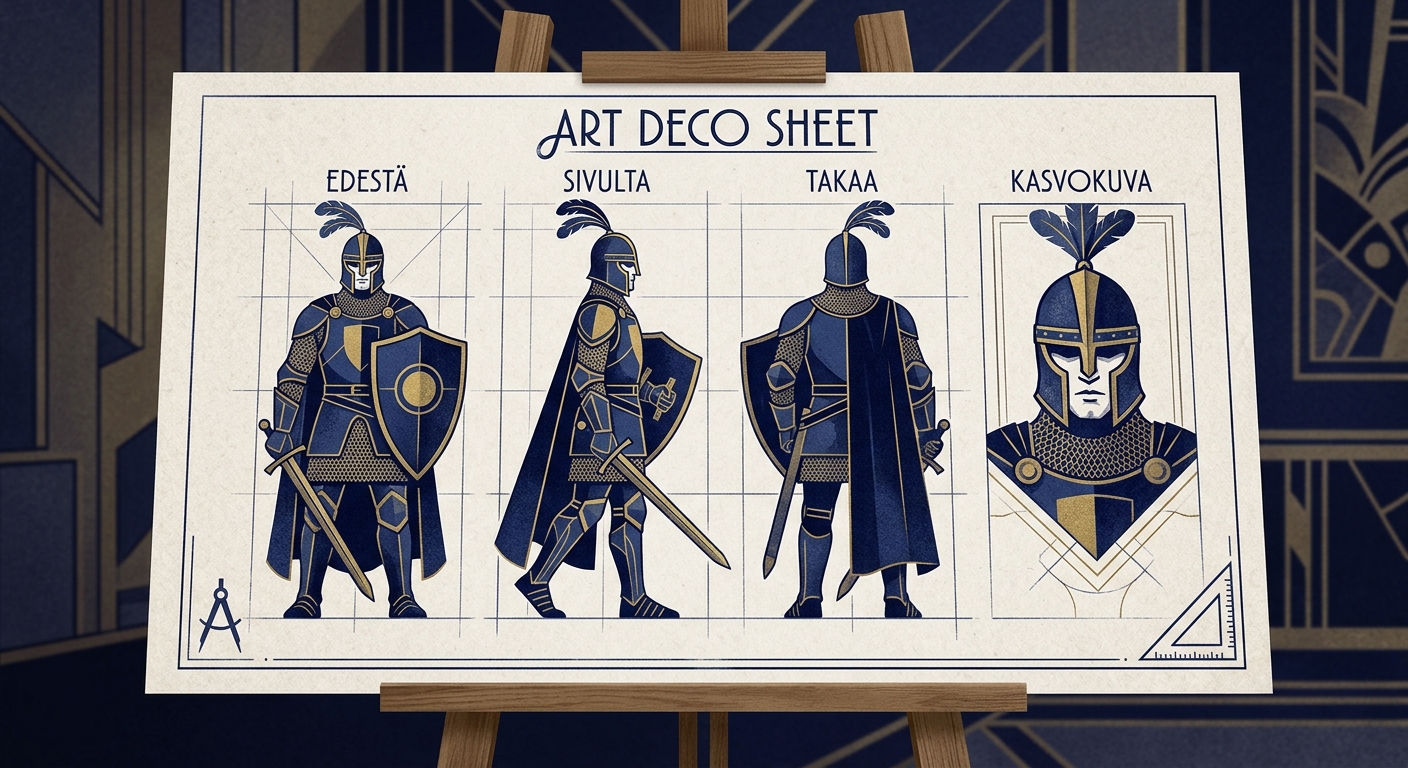
Ongelma, jonka hahmolomake ratkaisee, on jokaisen kuvittajan tuttu: kuvamallit eivät pidä hahmoa kasassa kuvien välillä. Kun saman hahmon generoi kuusi kertaa, saa kuusi serkusta — leuan linja elää, takin leikkaus vaihtuu, värit ajelehtivat. H3 Character Sheet Generator -työnkulun oivallus on, ettei johdonmukaisuutta kannata pyytää kuvamallilta, jolle se on toive, vaan videomallilta, jolle se on rakenteen ominaisuus. Työnkulku generoi yhden hitaan, leikkauksettoman kierron hahmon ympäri — hahmo seisoo kuin patsas, kamera kiertää — ja poimii videosta neljä tai kuusi ruutua valmiiksi lomakkeeksi ladottuna. Saman ajon ruudut eivät voi riidellä keskenään, koska ne syntyivät samasta laskennasta.
Käytännön työ alkaa referenssien kokoamisella, ja tässä yhdeksän kuvan sisäänotto pääsee oikeuksiinsa: kasvot voi ottaa yhdestä kuvasta, haarniskan toisesta ja hatun kolmannesta, ja H3 pitää yhdistelmän koossa. Yksi kehote kuvaa, mitä syötteet ovat, toinen hoitaa kierron, asennon ja valaistuksen. Ulos saa lomakkeen lisäksi halutessaan koko kiertovideon ja jokaisen ruudun erikseen, jos haluaa valita kulmansa itse. Valmis lomake on työkalu, ei lopputuote: se kelpaa identiteettireferenssiksi tuleviin ajoihin — H3:n omiin monikuvareferensseihin, LTX-puolen identiteettiputkiin ja CharacterID-työnkulkuihin — siemenaineistoksi hahmokohtaisen lisäosan koulutukseen, tai yksinkertaisesti sopimukseksi asiakkaan kanssa siitä, miltä hahmo näyttää. Se tehdään kerran ja käytetään sata kertaa.
Jos ison videomallin ajaminen tuntuu liialta, kuvapuolella on rinnakkaisreitti: saman trendilistan kärkeä pitävä CharacterSheet-kokoelma tekee lomakkeen muokkauslisäosana FLUX.2 Klein 9B:lle ja Krea 2:lle. TripleView ja QuadView tuottavat perinteisen etu–sivu–taka-asettelun, ja kokeellinen DynamicCharacterSheet laajentaa lomakkeen kokonaiseksi olentoarkiksi — sankariasento, kääntö, toiminta-asennot, siluetti- ja ilmetutkielmat — ja taipuu myös eläimiin, robotteihin ja esineisiin. Kokoelma on koulutettu noin kolmellasadalla lomake-esimerkillä, painopiste ihmishahmoissa; sen ulkopuolella tulokset vaihtelevat.
Rajat on hyvä tuntea. Videosta poimitut ruudut ovat videon tarkkuutta, eivät painokelpoista kuvitusta — lomake on referenssi, ei juliste. Tyylitellyt aiheet karkaavat helpommin kuin valokuvamaiset, ja H3-reitti vaatii ison mallin ajamisen, jota Turbo ja GGUF:t helpottavat mutta eivät poista. Silti työnkulun suosio kertoo jotain olennaista: yhteisön kärkihavainnot eivät ole tällä hetkellä uusia malleja, vaan uusia tapoja kysyä vanhoilta oikein.
Lähteet: H3 Character Sheet Generator, CharacterSheet-LoRAt, MiniMax-H3, H3 Turbo, Hugging Face API (image-to-image, trending 20.8.)
Nostot · kentältä ja verkosta
Kahdeksan mallia, yksi mittari: keskiviikkona yleisölle avautunut PixRoute-selainstudio ajaa kahdeksaa video- ja kuvamallia — muiden muassa Seedance 2.5:tä, Veo 3.1:tä ja Kling 3.0:aa — yhdellä krediittisaldolla ja tarjoaa ensimmäisen ja viimeisen ruudun ohjauksen mallista riippumatta. Ilmiö on suurempi kuin yksittäinen palvelu: kokoajapalvelut ovat videopuolen uusi kerros, jossa malli on vaihdettava osa ja työnkulku pysyy. Sama ajatus, jonka Modular Diffusers tekee avoimella puolella kirjastona, tapahtuu suljetulla puolella tuotteena.
Verkkokauppa leikkauspöydän ääressä: video-to-video-trendilistaa on elokuun ajan pitänyt hallussaan yllättävä taho — kiinalaisen verkkokauppajätti JD:n JoyAI-Video-Edit. Motiivi on ilmeinen, kun sitä ajattelee: tuotevideoita tarvitaan miljoonittain ja muokkaustarpeet ovat toistuvia ja kapeita. Kauppajätit ovat hiljaa nousemassa videomallien vakavasti otettaviksi julkaisijoiksi, koska niillä on se, mistä tutkimuslaboratoriot kilpailevat — loputon käyttötapaus.
Seuranta — Anima ei hellitä: pieni anime-malli Anima-2.9B, jonka juttusarja esitteli numerossa 003, pitää yhä koko tekstistä kuvaksi -trendilistan ykkössijaa selvällä erolla. Vielä kuvaavampaa on 48 tunnin uutuuslista: sinne ilmestyy Animan kopioita ja johdannaisia nyt päivittäin. Yhteisö äänestää lataamalla, ja äänet menevät tällä hetkellä pienelle, nopealle ja avoimelle — ei suurimmalle.
Suljetut edellä, avoimet perässä — väli kapenee: pelattavien maailmamallien näyttävimmät demot ovat kuluneen vuoden ajan tulleet suljetuista palveluista: Googlen Genie 3 on rajattu kutsuvieraille, ja selaimessa pyörivät maailmat ovat palveluita, eivät ohjelmistoja. Päivän uutisissa kerrottu ABot-Worldin Diffusers-paketointi on vastaveto toisesta suunnasta — ei näyttävin, mutta ladattavin. Avoimen puolen historia kuvamalleista videomalleihin on toistanut samaa kaavaa: vuosi perässä, kunnes ei enää ollutkaan.
Klassikko esittelyssä · 7/10
CLIP ja BLIP — silta, jonka päällä koko kenttä kävelee
Tammikuussa 2021 OpenAI julkaisi kaksi asiaa samana päivänä. DALL-E sai otsikot, koska se piirsi nojatuoleja avokadon muotoon. Toinen julkaisu, CLIP, näytti sivuosalta: järjestelmä, joka osaa sanoa, kuinka hyvin kuva ja teksti sopivat yhteen. Jälkikäteen järjestys on kääntynyt. DALL-E:n arkkitehtuuri on museossa; CLIP on jossain muodossa läsnä lähes jokaisessa kuvassa, jonka generatiivinen malli on sen jälkeen tuottanut. Idea oli riisuttu: kaksi enkooderia, toinen kuville ja toinen teksteille, koulutetaan 400 miljoonalla verkosta kerätyllä kuva–teksti-parilla vetämään oikeat parit samaan pisteeseen yhteisessä vektoriavaruudessa ja työntämään väärät kauas. Kuva ja lause muuttuvat saman avaruuden osoitteiksi — ja etäisyys tarkoittaa merkitystä.
Seuraukset tulivat kahdessa aallossa. Ensin CLIP oli ohjain: vuoden 2021 yhteisötaiteen ensimmäinen aalto syntyi, kun harrastajat kytkivät sen mittariksi generaattorin päälle ja antoivat sen vetää kuvaa kohti tekstin osoitetta. Sitten siitä tuli perusta: Stable Diffusion otti tekstintulkikseen CLIPin jäädytetyn tekstienkooderin — yhteisön slangiin jäänyt CLIP skip -asetus säätää juuri sitä, kuinka syvältä enkooderia tulkinta luetaan — ja avoimen kentän suuraineistot koottiin CLIP-samankaltaisuudella suodattaen. Sekin, mikä laskettiin "kauniiksi", oli CLIPin makua: suosituin esteettisyysmittari on pieni pää sen piirteiden päällä. Voi perustellusti sanoa, että avoimen kuvageneraation kaanon on CLIPin kuratoima.
Salesforcen BLIP vuodelta 2022 rakensi sillan toiseen suuntaan: se ei vain vertaa vaan kirjoittaa — antaa kuvalle kuvatekstin. Sen ovela ydin oli aineiston omavaraisuus: malli tuotti itse kuvatekstejä ja suodatti itse huonot pois, ja parani syömällä omaa, siivottua jälkeään. BLIP-2 vei ajatuksen pidemmälle kytkemällä jäädytetyn näköenkooderin jäädytettyyn kielimalliin pienellä välittäjämoduulilla — resepti, jonka muunnelmia nykyiset multimodaalimallit yhä ovat. Arjessa BLIPin perintö on proosallinen ja kaikkialla: käytännössä jokainen lisäosakoulutus alkaa sillä, että jokin BLIPin jälkeläinen kirjoittaa aineistolle kuvatekstit.
Kumpikaan ei ole poissa. Alkuperäinen BLIP-kuvatekstittäjä on tänäkin päivänä kuvasta tekstiksi -listan kärjessä yli kahden miljoonan kuukausilatauksen voimin — nelivuotias malli, mikä on tällä alalla geologinen ikä. CLIPin suku jatkuu SigLIP-linjassa, jonka tuoreinta polvea käyttää muun muassa tämän numeron Lyhyissä esitelty V-RAE. Ja silta itsessään on muuttunut näkymättömäksi juuri niin kuin perustavat teknologiat muuttuvat: kukaan ei enää mainitse, että kehote ylipäätään toimii. Se, että sanat osaavat osoittaa kuviin ja kuvat sanoihin, on se hiljainen sopimus, jonka CLIP ja BLIP neuvottelivat — ja jonka päällä tämäkin lehti kävelee joka aamu.
Sarjassa seuraavaksi: Segment Anything (SAM).
Pikselipaino · Nro 007 · 20.8.2026