Pikselipaino
Pääkirjoitus
Valokuvauksen ankarin sääntö on ollut, että kuvakulma valitaan ennen laukaisua. Kamera seisoo jossakin, ja se jossakin on kuvan peruuttamaton ominaisuus — sommittelun voi rajata uusiksi, värit voi vetää toiseen suuntaan, mutta katselupistettä ei siirretä jälkikäteen. Tämän päivän lehti kertoo, miten juuri tämä sääntö natisee. Generoidussa maailmassa näkökulman voi nyt vaihtaa kesken kaiken omista silmistä olan taakse, stillkuvalta voi tilata jälkikäteen kymmeniä uusia kamera-asemia, ja käsivaralla kuvattu video oppii kiertämään kohteensa ympäri vasta editointipöydällä. Kamera on irtoamassa kuvasta: siitä on tulossa jälkituotannon säädin, siinä missä valotus ja rajaus ovat olleet jo vuosikymmenen.
Päätöksen hetki ei silti katoa — se siirtyy ja monistuu. Kun mikään kulma ei ole lopullinen, valinta muuttuu kuvaajan refleksistä leikkaajan harkinnaksi: mikä näistä kulmista kertoo asian, eikä vain näytä sitä. Ja yksi raja pysyy paikallaan sielläkin, missä kamera liikkuu vapaasti. Se, mitä mikään linssi ei koskaan nähnyt, on mallin arvausta — uskottavaa, usein käyttökelpoista, mutta arvausta. Uusi kulma näyttää siltä kuin joku olisi seissyt paikalla. Sunnuntain kunniaksi muistutamme: kukaan ei seissyt.
Uutiset
Generoitu maailma oppi vaihtamaan olkakameraan
Avoimen LingBot-World-maailmamallin päälle julkaistiin tänä aamuna lisäpainot, jotka vaihtavat näkökulman ensimmäisestä persoonasta kolmanteen — kesken generoinnin, saman maailman jatkuessa ympärillä.
Pelisuunnittelun vanhimpia valintoja on, katsooko pelaaja maailmaa omin silmin vai hahmonsa olan takaa. Valinta tehdään suunnittelupöydällä ja siihen sitoudutaan — moottori, animaatiot ja kentät rakennetaan sen ehdoilla. Videopohjaisissa maailmamalleissa sama valinta on tähän asti lyöty lukkoon vielä aikaisemmin, koulutusdatassa. Tänä aamuna Hugging Faceen ilmestynyt SwitchWorld tekee siitä ajonaikaisen kytkimen: generointi jatkuu, mutta katse siirtyy omista silmistä hahmon taakse ja tarvittaessa takaisin, ilman leikkausta ja ilman että maailma vaihtuu toiseksi.
Pohjana on tammikuussa avoimena julkaistu LingBot-World, Ant-konsernin robotiikkayhtiön Robbyantin maailmasimulaattori, joka ajaa generoitua näkymää tosiaikaisesti — kuusitoista ruutua sekunnissa alle sekunnin viiveellä — ja pitää ympäristön koossa minuuttien mittaisissa ajoissa. SwitchWorld on siihen koulutettu lisäpainojen sarja mallin molemmille kohinahaaroille. Koulutus eteni kolmessa vaiheessa: ensin oma ekspertti ensimmäisen persoonan näkymälle, sitten toinen kolmannelle, ja lopuksi pelkkä siirtymäosa muiden painojen ollessa jäädytettyinä. Kortti julkaisee lopullisten painojen rinnalla myös välivaiheet, jotta koulutuspolun voi toistaa tai purkaa osiin — tutkimusjulkaisuksi poikkeuksellisen siistiä kirjanpitoa.
Kiinnostavin kohta on itse vaihdoksen hetki. Kun näkymä siirtyy silmistä olan taakse, kuvaan on ilmestyttävä jotain, mitä missään aiemmassa ruudussa ei ollut: oma hahmo takaapäin, oikean kokoisena ja oikeassa kohdassa, samalla kun ympäröivän maailman on pysyttävä täsmälleen paikoillaan. Se on ankara muistikoe — malli ei voi kopioida hahmoa mistään, sen on tiedettävä missä kantaja seisoo, vaikka tämä ei ole näkynyt kertaakaan. Tekijöiden tulosgalleria näyttää, miltä onnistunut vaihto näyttää eri ympäristöissä; paperi lasketaan liikkeelle arXivin kautta LingBot-Worldin jatkona.
Käyttöön lähtevälle on syytä sanoa suoraan: kyse on tutkimuskoodista, ei valmiista työkalusta. Painot vaativat LingBot-World-perusmallin erikseen, ajaminen tapahtuu tekijöiden omalla koodilla, ja laitteistovaatimukset ovat perusmallin luokkaa. Suunta on silti selvä ja koskee muitakin kuin pelintekijöitä: pelikameroiden kielioppi — ajokamera, olkakamera, ohjaamonäkymä — on siirtymässä generoituihin maailmoihin kerronnan välineeksi, ja tällä kertaa avoimena.
Lähteet: SwitchWorld-mallikortti (30.8.2026), LingBot-World-perusmalli, tulosgalleria, LingBot-World-raportti (arXiv)
Silta, jota kukaan ei piirtänyt
OpenTO-hankkeen tänään julkaisema TopoDiT generoi kantavia rakenteita: annat kiinnityskohdat, kuormat ja materiaalibudjetin, malli ehdottaa muodon. Konehuone on sama kuin kuvamalleissa — mutta hyvyyden tuomarina on lujuuslaskenta, ei silmä.
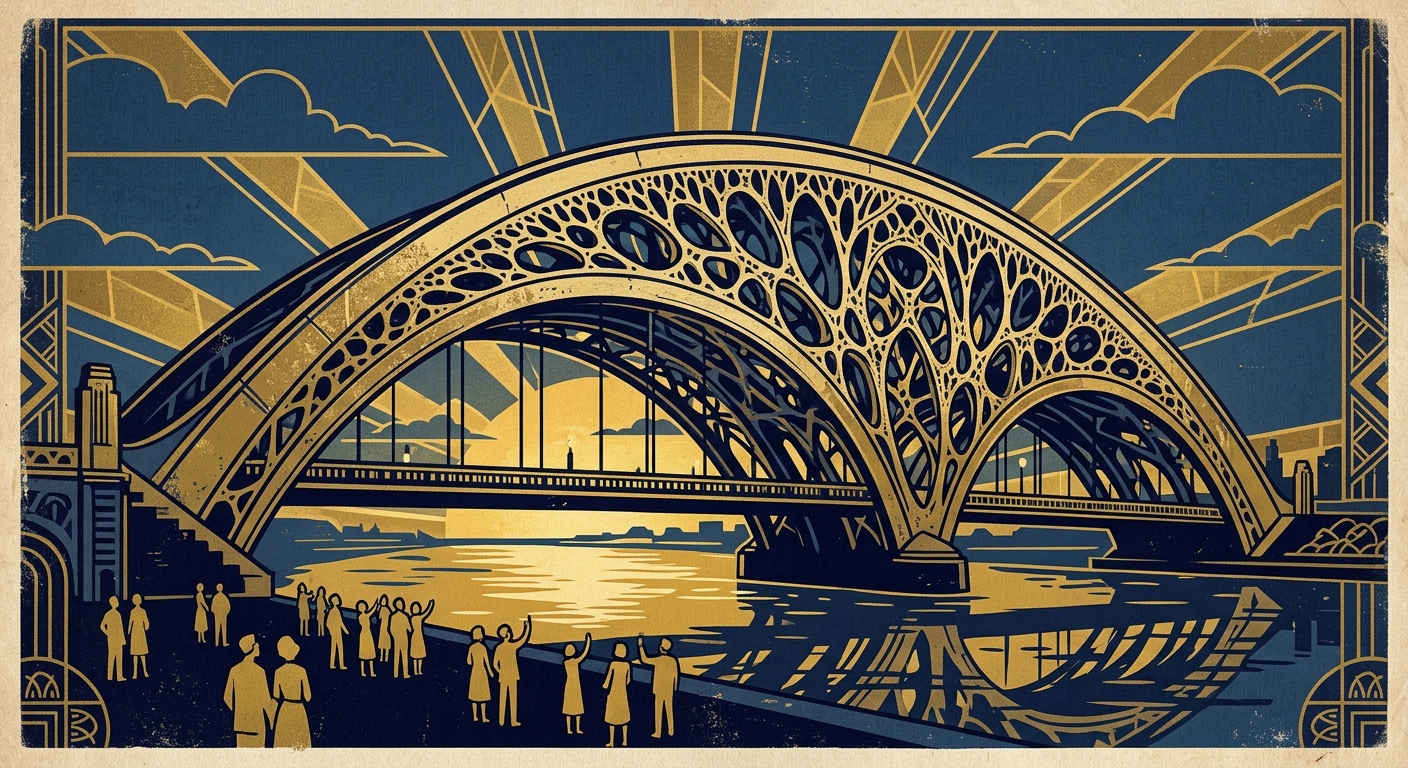
Topologiaoptimointi on insinöörityön laji, jossa muotoa ei piirretä vaan se ratkaistaan. Suunnittelija antaa alueen, kiinnityspisteet, kuormat ja materiaalin enimmäismäärän; laskenta etsii muodon, joka taipuu kuormien alla mahdollisimman vähän. Tulokset näyttävät tutunoudoilta — luiden huokoisilta ristikoilta, puiden haarautumilta — koska evoluutio on ratkonut samaa tehtävää samoin ehdoin. Perinteisesti haku tehdään iteroimalla: elementtimenetelmän simulointikierroksia kymmenittäin tai sadoittain, jokainen hidas. Siksi ala on ollut generatiivisten mallien luonteva kohde: jos muodon voi arvata suoraan, iteraatiot jäävät pois.
TopoDiT on tämän arvaajan uusin ja toistaiseksi osuvin versio: 689 miljoonan parametrin diffuusiotransformeri, koulutettu flow matching -menetelmällä jäädytetyn autoenkooderin latenttiavaruuteen. Resepti on pikseliä myöten sama kuin tämän lehden vakioaiheissa — arkkitehtuuri kuin kuvamalleissa, autoenkooderi kuin numerossa 005, ja jatkuvana kenttänä esitetty tulos on sukua numeron 009 säteilykentille. Neuraalikenttä tarkoittaa, ettei rakenne synny pikseliruudukkona vaan funktiona, jolta voi kysyä materiaalin määrää missä pisteessä tahansa: sama malli palvelee mitä tahansa resoluutiota ja kuvasuhdetta. Syötteiksi käyvät alueen muoto, laskentaverkon tiheys, tavoiteltu materiaaliosuus sekä reunaehdot ja kuormat.
Luvuissa harppaus on selvä. Viiden tuhannen testitehtävän erässä edeltäjän — viime syksynä NeurIPS-konferenssissa esitellyn Optimize Any Topologyn — yksittäinen arvaus epäonnistui 40 prosentissa tehtävistä; TopoDiT:llä osuus putoaa 21,8:aan. Onnistuneiden ehdotusten jäykkyysvirheen mediaani putosi 3,94 prosentista 0,46:een. Ja kun malli arpoo neljä ehdokasta, simulaattori valitsee parhaan ja kymmenen viimeistelyaskelta hioo sen, epäonnistumisia jää 5,8 prosenttia. Työnkulku on tuttu jokaiselle kuvamallien käyttäjälle — generoi monta, valitse paras — mutta valitsijana ei ole maku vaan fysiikka, joka antaa jokaiselle ehdokkaalle kiistattoman arvosanan.
Lukijalle, joka ei suunnittele siltoja, uutinen on silti merkillepantava kahdesta syystä. Ensinnäkin se näyttää, miten kuvamallien koneisto valuu tehtäviin, joissa oikeellisuus on mitattavaa — raja kuvan tekemisen ja suunnittelun välillä ohenee molempiin suuntiin. Ja toiseksi: lavastajille, pelimaailmojen rakentajille ja 3D-tulostajille topologiaoptimoinnin muotokieli on löytö jo sellaisenaan. Se on estetiikkaa, jota ei voi huijata, koska jokainen kaari on jossakin kannattamassa jotakin. Malli, koodi ja koulutusdata ovat avoimesti MIT-lisenssillä.
Lähteet: mallikortti tuloksineen (30.8.2026), NFAE-autoenkooderi, Optimize Any Topology -artikkeli (NeurIPS 2025), OpenTO-aineisto
Pakkaamo kysyy ensin, paljonko muistia sinulla on
Kielimalleja mittatilauspakkauksina myynyt RAM-linjasto otti tänä aamuna ensimmäisen kuvamallin: Krea 2 Turbosta ilmestyi kolme Mac-rakennetta, joiden nimessä ei lue bittimäärä vaan gigatavut.
Tavallinen tapa julkaista kevennetty malli on valita bittileveys — neljä bittiä, kahdeksan bittiä — ja pakata kaikki painot samalla muotilla. Baa.ai-nimisen tekijän RAM-linjasto on keväästä asti kääntänyt järjestyksen kielimallien puolella, ja tänä aamuna sama käsittely ulottui ensi kertaa kuvamalliin. Krea 2 Turbon RAM-rakenteissa jokaisen tensorin herkkyys pakkaamiselle mitataan ensin erikseen, ja sitten ratkaistaan optimointitehtävänä, minkä bittileveyden kukin tensori saa, jotta laatu on paras mahdollinen annettuun muistirajaan mahtuen. Tehtävätyypillä on nimikin: monivalintainen reppuongelma — reppuun pakataan arvokkainta mitä rajaan mahtuu, paitsi että repun koko on Macin muisti ja tavarat ovat tensorien tarkkuuksia.
Lopputulos näkyy jo repojen nimissä: ostoksille ei mennä bittimäärä vaan muistibudjetti edellä. Yhdeksän gigatavun rakenne on kortin mukaan "tehokkuuspolvi", paras laatu gigatavua kohden: keskimäärin 4,97 bittiä, mutta jakauma vaihtelee tensoreittain neljästä kahdeksaan — 57 tensoria neljällä bitillä, 76 kahdeksalla, loput siltä väliltä. Tekstiä tulkitseva enkooderi on jätetty kokonaan pakkaamatta, koska sen keventäminen näkyi suoraan kehotteen noudattamisessa. Yhdeksäntoista gigatavun versio jättää 184 tensoria 256:sta täysin koskematta, ja kortti toteaa itsekin useimmille riittävän pienemmän. Sekatarkkuudella on hintansa: ajoympäristön metatiedot tuntevat vain yhden pakkausluvun koko mallille, joten paketissa tulee mukana oma lataaja.
Eilisessä numerossa nähtiin saman ilmiön nurja puoli: pakkausvika voi asua yhdessä ainoassa tensorissa, jonka keskiarvomittari ei paljasta. RAM-linjasto on sama havainto käännettynä työkaluksi — jos herkkyys on tensorikohtaista, myös bittibudjetti kannattaa jakaa tensoreittain, mitaten eikä arvaten. Ja numeron 003 kysymykseen, kuinka monta bittiä kuva oikeastaan tarvitsee, on nyt entistä täsmällisempi vastaus: se riippuu tensorista, ja sen voi laskea — sinun koneesi muistiin sovittaen. Pakkaamisesta on tulossa mittatilaustyötä. Kerro räätälille rammisi, saat siihen istuvan mallin.
Lähteet: RAM-9GB-kortti (30.8.2026), RAM-19GB-kortti, Krea 2 Turbo, mflux-ajoympäristö
Lyhyet
Kasvot koottiin osista: tutkimusryhmän virallisena koodijulkaisuna ilmestynyt FaceComposer siirtää muotokuvaan yksittäisiä piirteitä viitekuvasta — kulmakarvat, silmät, nenän tai suun — säilyttäen lähdekuvan asennon, ilmeen ja valaistuksen. Kasvopalstalla on menty kokonaisuuksista osiin: numerossa 011 vaihdettiin kasvot, numerossa 015 pidettiin sama kasvo sarjassa, nyt muokataan piirre kerrallaan. Lupasääntö ei muutu miksikään: viitekasvotkin ovat jonkun. mallikortti (30.8.2026)
Ikkunapaikan kirous hellittää: junan tai lentokoneen ikkunan läpi kuvatuista otoksista voi pyyhkiä hytin heijastukset WindowSeat-lisäpainolla, joka istuu Qwen-kuvaeditorin päälle ja toimii ilman esimerkkiopetusta uusissa tilanteissa. Tänään palstalle nostetun talvisen tutkimuksen voi kokeilla suoraan selaimessa — sama vaiva koskee näyteikkunoita ja museovitriinejäkin. selainkokeilu · artikkeli
Videon pikaversio purjehti Mac-satamaan: Wanin kevytrungosta tislattu FastWan, joka generoi videota kolmella kohinanpoistoaskeleella, kvantattiin Applen MLX-ajoympäristöön kahdeksalla bitillä. Kuvamallien Mac-muutto on jatkunut palstalla viikkoja — nyt samaa reittiä kulkee liikkuva kuva. mallikortti (30.8.2026)
Näkymättömän valon kuvat siistiytyvät: lyhytaaltoisella infrapuna-alueella kamera näkee sumun ja monien materiaalien läpi, mutta kennot kohisevat pahasti. ICCV-työpajassa esitelty See the Invisible with SWIR julkaisi kohinanpoistomallinsa painot — ja poikkeuksellisen rehellisen kirjanpidon: kortti dokumentoi myös sen, että kaksi koetta tallentui vahingossa samaan nimiavaruuteen, eikä säilynyttä painoa siksi väitetä kummaksikaan. Eilisen numeron arkistoteema jatkuu: provenienssi kirjattiin ennen kuin kukaan ehtii siteerata väärin. mallikortti (30.8.2026)
Asennontunnistus eteni heinäsirkkoihin: avainpistepalstan ainoa 48 tunnin tulokas on RF-DETR-pohjainen malli, joka paikantaa heinäsirkan nivelet — tuntosarvista takajalkoihin. Ihmisasennoista alkanut tekniikka on kulkenut hiirten ja hevosten kautta hyönteisiin; biologin liikeanalyysi käyttää samoja työkaluja kuin animaattorin referenssikirjasto. mallikortti (29.8.2026)
Mitä tällä oikeasti tekee
Kuvalle uudet kulmat
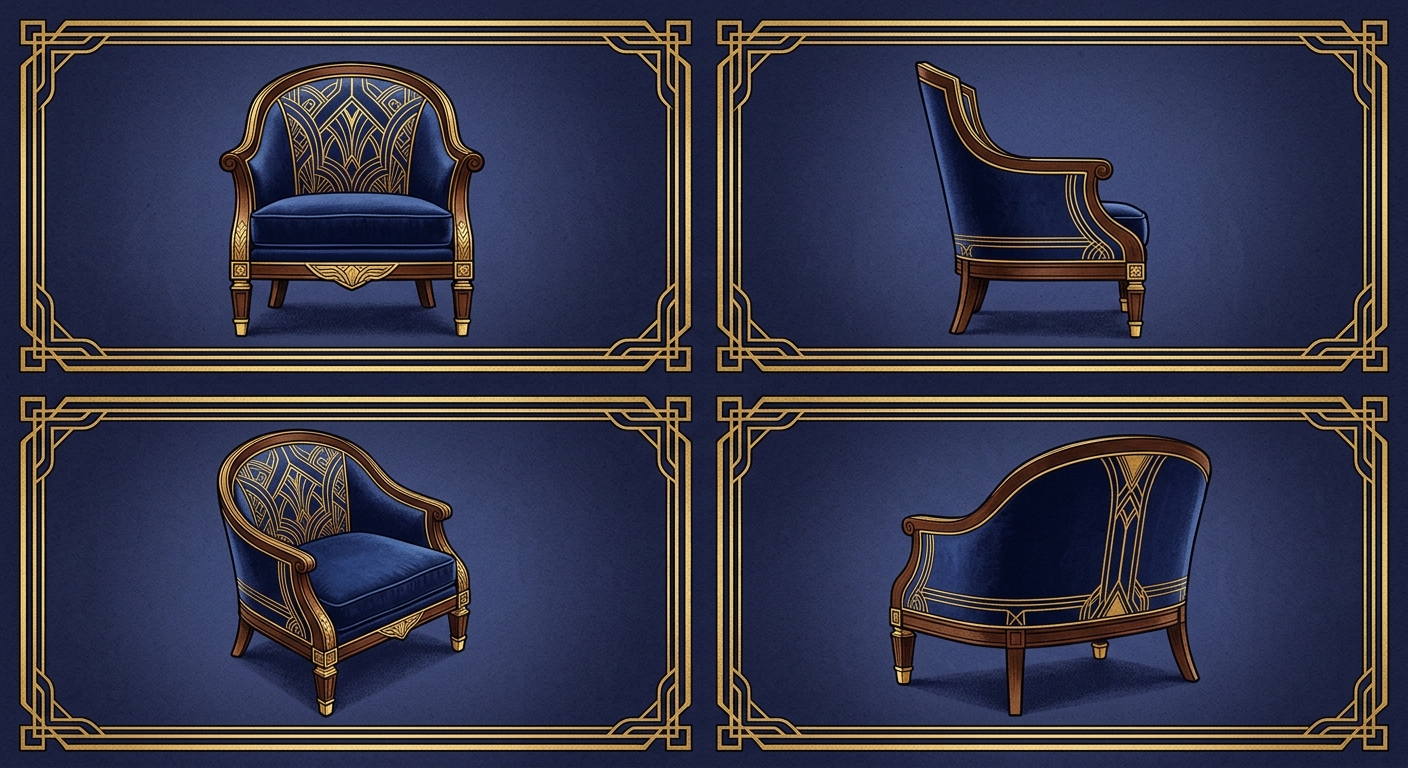
Kuvassa on aina yksi kamera, ja se seisoo väärässä paikassa täsmälleen silloin, kun kuvaa tarvitaan toiseen käyttöön. Qwen-kuvaeditorin ympärille on kasvanut lisäpainojen perhe, joka ratkoo juuri tätä: annat yhden kuvan ja pyydät kameran toisaalle — ylemmäs, sivummalle, lähemmäs, matalalle. Marraskuussa ilmestynyt alkuperäinen kulmapaino teki tempusta yhteisön vakiotyökalun, ja perjantaina sarja sai jatkoa: uusi versio tuoreimmalle editorisukupolvelle kattaa 96 kamera-asemaa — kahdeksan suuntaa, neljä korkeutta matalakulma mukaan lukien, kolme etäisyyttä — ja sen opetusparit on renderöity Gaussin splateista, jotta geometria pysyy kulmasta toiseen aidosti samana. Kolmiulotteinen tallennusmuoto opettaa siis kaksiulotteista editoria; numeron 009 klassikko palasi töihin opettajana.
Tuotekuvasta katalogisarja. Verkkokaupan tuotesivu kaipaa vakiokulmat: edestä, viistosta, sivulta, ylhäältä. Kun käsillä on yksi kunnollinen otos, kulmapaino generoi loput sarjasta — samalla taustalla ja valolla, mikä on sarjan uskottavuudelle tärkeämpää kuin yksittäisen kuvan täydellisyys. Tarkista mittasuhteet joka kuvasta: kamera on helppo siirtää, esineen leveys-korkeussuhde lipsuu herkemmin.
Puuttuvat kulmat ennen 3D-vaihetta. Kuvasta kolmiulotteiseksi -mallit (sarjan osa 1) toimivat sitä paremmin, mitä useampi näkymä niille annetaan. Yhdestä konseptikuvasta voi generoida kierroksen — edestä, sivuilta, takaa — ja syöttää koko sarjan 3D-malliin tai mallintajalle referenssiksi. Takapinta on rehellisesti mallin arvaus: hahmon selkämyksen yksityiskohdat kannattaa lukita itse ennen kuin ne päätyvät peliassetiksi asti.
Vastakulma ja yleiskuva kuvakäsikirjoitukseen. Sarjakuvan tai kuvakäsikirjoituksen kohtaus tarvitsee saman miljöön monesta suunnasta: keskustelu leikkautuu vastakulmiin, kohtaus avataan yleiskuvalla. Kulmapaino pitää huoneen kalusteineen samana, joten jatkuvuus säilyy ilman että miljöötä mallinnetaan mihinkään. Sisustajan ja kiinteistövälittäjän versio samasta tempusta: huonekuva siitä nurkasta, josta kukaan ei muistanut kuvata.
Miten ajetaan. Painot istuvat Qwen-Image-Edit-editoriin, jota ajetaan ComfyUI:ssa tai diffusers-kirjastolla; ohjaus on pelkkää tekstiä kehotteessa — käännä vasemmalle 45 astetta, nosta yläviistoon, siirry lähikuvaan. Kotikoneita varten editorista ilmestyivät tällä viikolla myös kevennetyt INT4- ja FP8-paketit. Ja työnjaon raja on sama kuin aina: tämä on kuvitusta ja esisuunnittelua, ei mittaus- tai todistusaineistoa. Kun kulman pitää olla totta — rikospaikka, rakennusdokumentointi, museoesine — kuvataan monta kuvaa tai skannataan splatiksi, eikä anneta mallin arvata. Sarjassa aiemmin: samaa vakiointiperiaatetta on käytetty asentoon (014), kasvoihin (015) ja liikkeeseen (016); nyt vakioidaan kohde ja liikutetaan katsojaa.
Lähteet: uuden kulmapainon kortti (29.8.2026), alkuperäinen Multiple Angles, Qwen-Image-Edit-2511, INT4-paketti (29.8.2026)
Nostot · kentältä ja verkosta
Käsivaravideo oppi kiertämään kohteensa: videopalstan trendilistaa kipuaa Ant-tutkimuksen 4DAnyone, joka muuntaa yhden tavallisen puhelinvideon moninäkymävideoiksi — ikään kuin kohtausta olisi kuvannut kamerarinki — ja niistä edelleen liikkuvaksi kolmiulotteiseksi splat-tallenteeksi. Sama konserni on esillä tämän numeron pääjutussa maailmamallinsa kanssa; kulmien jälkikäteinen vapauttaminen on selvästi talon teema. Lisenssit ovat osakohtaisia, joten tuotantokäyttöön lähtevän kannattaa lukea nippu läpi. projektisivu · artikkeli (arXiv, elokuu 2026)
Hahmolomake istuu yhä valtaistuimella: kuvamuokkauksen trendilistan kärkipaikkaa pitää edelleen pelkkänä JSON-työnkulkuna julkaistu hahmolomakegeneraattori — ohi FLUX.2:n ja muiden varsinaisten mallien. Juttusarja käsitteli lomakeilmiötä numerossa 007 ja työnkulkujen kuratointikulttuuria eilinen nosto; kärkisija ilman ainuttakaan painotiedostoa on ilmiölle jo melkein virallinen sinetti. työnkulun kortti · HF-trendilista 30.8.
Listan kärjessä istuu kaksivuotias: kuvageneroinnin trendiykkönen ei tänään ole kukaan tämän kesän tulokkaista vaan FLUX.1-dev, heinäkuussa 2024 julkaistu klassikko (sarjan osa 001). Selitys ei ole nostalgia vaan painovoima: kahden vuoden kerrostuma lisäpainoja, ohjaimia ja työnkulkuja tekee vanhasta mallista sen, jolla asiat saa varmimmin tehtyä. Uutuus on tämän lehden polttoainetta, mutta ekosysteemi — se on valuuttaa. mallikortti · HF-trendilista 30.8.
Pikselipaino · Nro 017 · 30.8.2026